摘要 从 UNet 到 DiT,再到 MMDiT,生成模型的架构演进体现了计算资源分配方式的变化:UNet 以多尺度结构组织视觉计算,DiT 通过规整的 Transformer 主干扩展模型容量与空间处理粒度,MMDiT 则以模态独立参数和联合 attention 扩展图文交互能力。本文分为三章:第一章梳理模型容量、空间粒度与模态交互三个 scaling 维度;第二章结合 DiT 的模型规模与 patch 大小实验,分析参数量、计算量与生成质量的关系;第三章比较不同图文交互架构,并结合 MMDiT 的实验讨论归纳偏置、参数共享,以及模型容量与训练预算的协同扩展。贯穿全文的问题是:多模态生成如何安排架构和参数,才能持续转化为生成质量的提升。
第一章 架构 Scaling 中的几个关键维度
关于生成架构的 scaling,“增加了什么”与“这些增加是否带来收益”,本文关注以下几个维度:
模型容量:增加多少参数,放在哪里。 深度和隐藏宽度决定主干的容量,而架构决定这些容量如何分配。UNet 需要在不同空间尺度之间分配层数与通道;DiT 使用重复的 Transformer blocks,使加深、加宽成为更规整的扩容路径;MMDiT 又将容量分配到图像和文本各自的分支。需要检验的是:容量增加后,模型能否持续改善生成质量与条件执行能力。
空间粒度:用多少 tokens 处理一幅图像。 扩展计算并不一定需要增加很多参数。在输入分辨率不变时,减小 latent patch 可以增加 token 数,使更多空间位置被独立处理,但也提高 attention 的计算成本。UNet 的多尺度结构与 DiT 的 patch size,体现了对空间粒度的不同安排。这也是为什么参数量相近的模型,也可能具有不同的计算量与生成效果。
模态交互:条件信息如何进入主干并参与计算。 当条件从类别扩展到包含多个对象与关系的文本,仅扩大视觉主干未必足够。模型还需要合适的条件访问方式:通过全局向量调制、由图像读取文本,或者让图文状态联合更新。是否共享模态参数、交互发生在哪些层,决定新增容量如何用于图文关系建模。这是 DiT 到 MMDiT 的关键设计问题。
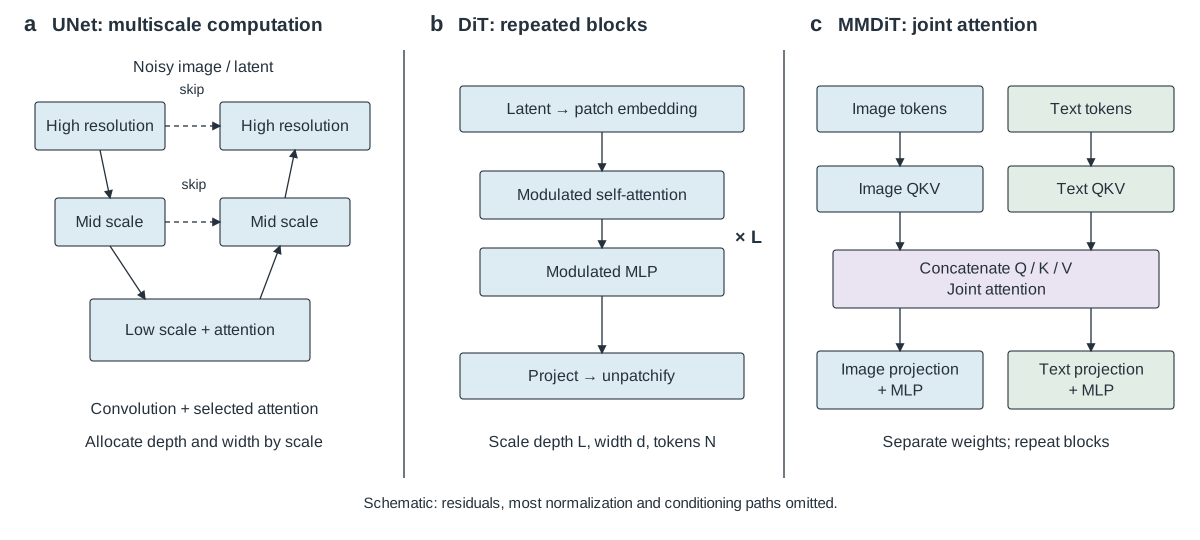
图1|三种主干的计算组织。a,UNet 在多个空间尺度间传递信息,跳跃连接保留细节。b,DiT 将 latent 切成 patch tokens,堆叠相同类型的 Transformer block。c,MMDiT 的图文两路使用各自的参数,在联合 attention 中交换信息。图中省略多数归一化、残差和调制连接,时间条件在真实网络中作用于多个 block。
第二章 从 UNet 到 DiT:模型容量与空间粒度带来的 Scaling
DiT 保留 latent 生成框架,以 patch embedding、重复 Transformer blocks 和输出投影替代多尺度 UNet。原始论文主要研究类别条件 ImageNet 生成,在模型宽度、深度和 patch 大小上进行系统比较;其设置中,更高的前向 GFLOPs 与更好的 FID 相关。[3]
这里有两种不同的增长方式。增加深度和宽度,主要增加参数容量;减小 patch,则在基本不改变主干参数规模的情况下增加 token 数。设 latent 大小为 ,patch 边长为 ,则
为层数, 为隐藏维度。第一项包括 QKV、输出投影和 MLP;第二项来自 attention 的位置交互。该近似省略调制、输入输出层及常数,不能替代硬件测量。
以 latent 为例, 得到 64 tokens, 得到 256 tokens。token 数增加四倍,线性项约增加四倍,attention 二次项约增加十六倍。输入信息并没有凭空增加,变化的是模型能独立处理和路由信息的空间粒度。
实验证据:容量与空间粒度都能带来收益。 原论文在类别条件 ImageNet 上训练了 12 个配置:S、B、L、XL 四种主干,分别搭配 三种 latent patch 大小。四种主干的“层数/隐藏宽度”依次为 12/384、12/768、24/1024、28/1152;因此这是一组深度与宽度组合的规模比较,并非对两者完全独立的消融。[3, Table 1, §5]
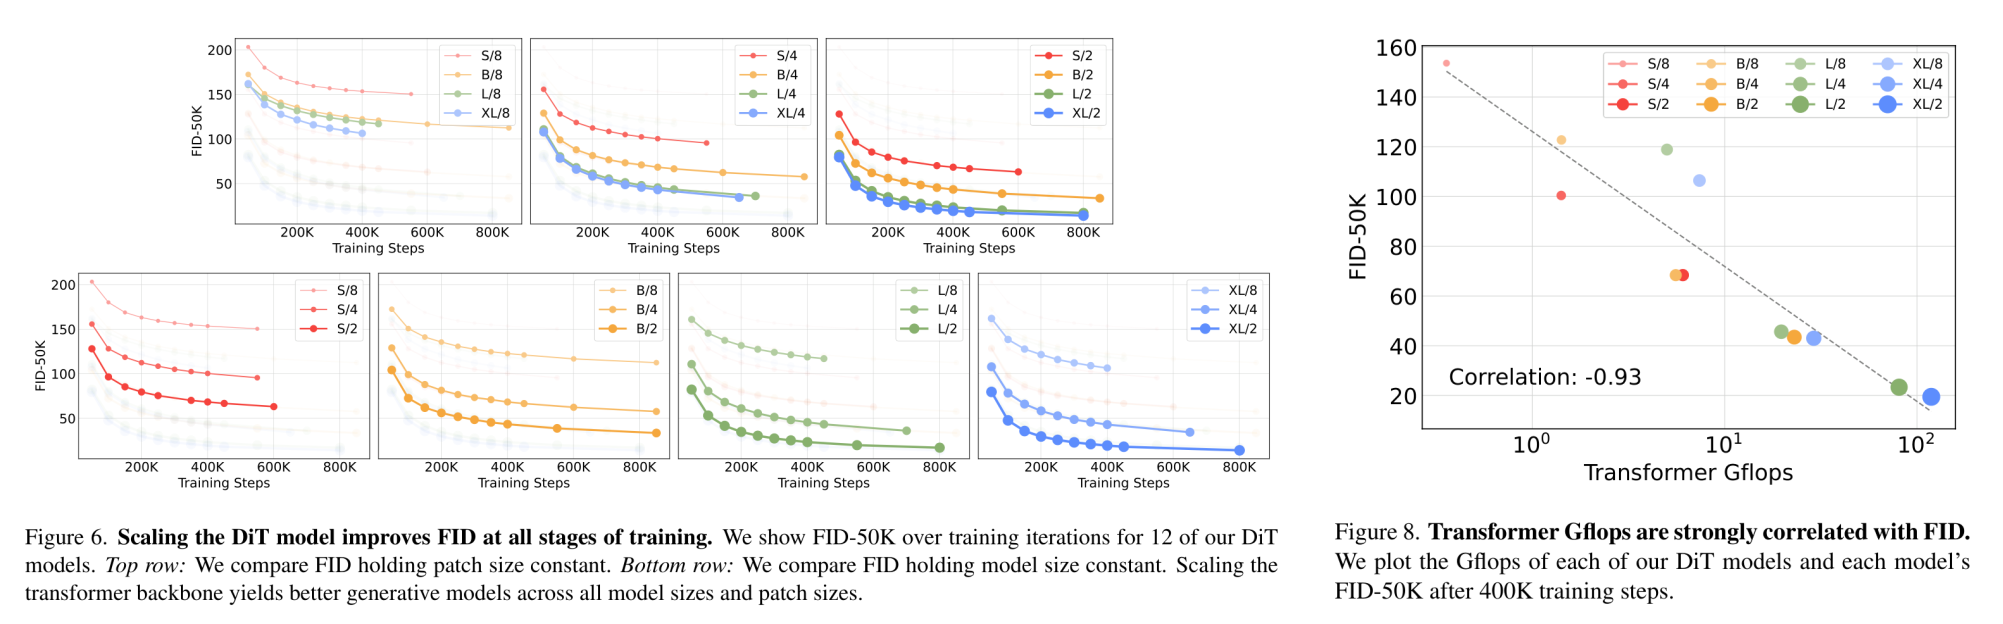
实验证据|左:DiT 原论文 Figure 6,上排固定 patch 大小、比较模型规模,下排固定主干规模、比较 patch 大小;横轴为训练步数,纵轴为 FID-50K,越低越好。右:Figure 8,12 个配置统一训练 40 万步后的 Transformer 前向 GFLOPs 与 FID-50K;横轴为对数刻度,图中标注的相关系数为 −0.93。这组 scaling 实验使用 250 步 DDPM 采样,不使用 classifier-free guidance。原图仅做等比例横向排版,未重绘;可打开横排大图放大查看。

左图上排表明,在相同 patch 大小下,更大的主干在所展示训练阶段获得更低 FID;下排则表明,即使主干参数规模基本不变,减小 patch、增加 tokens 仍能显著改善 FID。后一项尤其重要:生成质量不仅取决于有多少参数,还取决于这些参数在多少空间位置上参与计算。
Figure 8 将两条扩展路径放到同一个计算量坐标下:更高的前向 GFLOPs 总体对应更低的 FID,计算量相近的配置也可能达到相近质量,例如 DiT-S/2 与 DiT-B/4。[3, §5] 但这里固定的是训练步数,并非总训练 FLOPs;单次前向更贵,也意味着同样步数下投入了更多训练计算。因此,这张图支持该实验范围内的计算量—质量相关性,不能单独证明在固定总预算下,最大模型或最小 patch 总是最优。
因此,DiT 的优势不应仅被解释为“全局感受野”。它还提供了结构统一的扩容坐标,使模型大小和 token 粒度能被分别研究。标准化的大矩阵运算也便于复用 Transformer 的并行与优化工具。不过,规整性并不能自动保证同预算下的最优质量;这仍取决于训练时长、数据和具体实现。
第三章 从 DiT 到 MMDiT:跨模态交互下的 Scaling
3.1 架构对比
前面的架构演进涉及两类选择:如何组织视觉计算,以及如何让文本参与生成。MMDiT 论文在 CC12M 上比较了拼接文本的 DiT、CrossDiT、UViT 和 MMDiT,使这两类设计能够在同一组训练实验中接受检验。[4, §5.2.3]
| 主干 | 对比中的设计 | 所检验的选择 |
|---|---|---|
| 拼接文本的 DiT | 图文 tokens 拼接,使用共享参数处理 | 直接把类别生成主干扩展为统一的图文序列 |
| CrossDiT | 图像主干通过 cross-attention 读取文本 tokens | 为条件信息设置独立的读取路径 |
| UViT | 结合 UNet 与 Transformer 特征的混合架构 | 保留多尺度视觉结构是否仍有优势 |
| MMDiT | 图文使用独立参数,通过联合 attention 交互 | 同时保留模态专门化与双向信息交换 |
这里的“DiT”是实验中加入文本 token 拼接的版本,不是仅通过类别向量调制的原始类别条件模型。UViT 则作为视觉主干的参照,使比较不局限于几种图文 attention 接口。
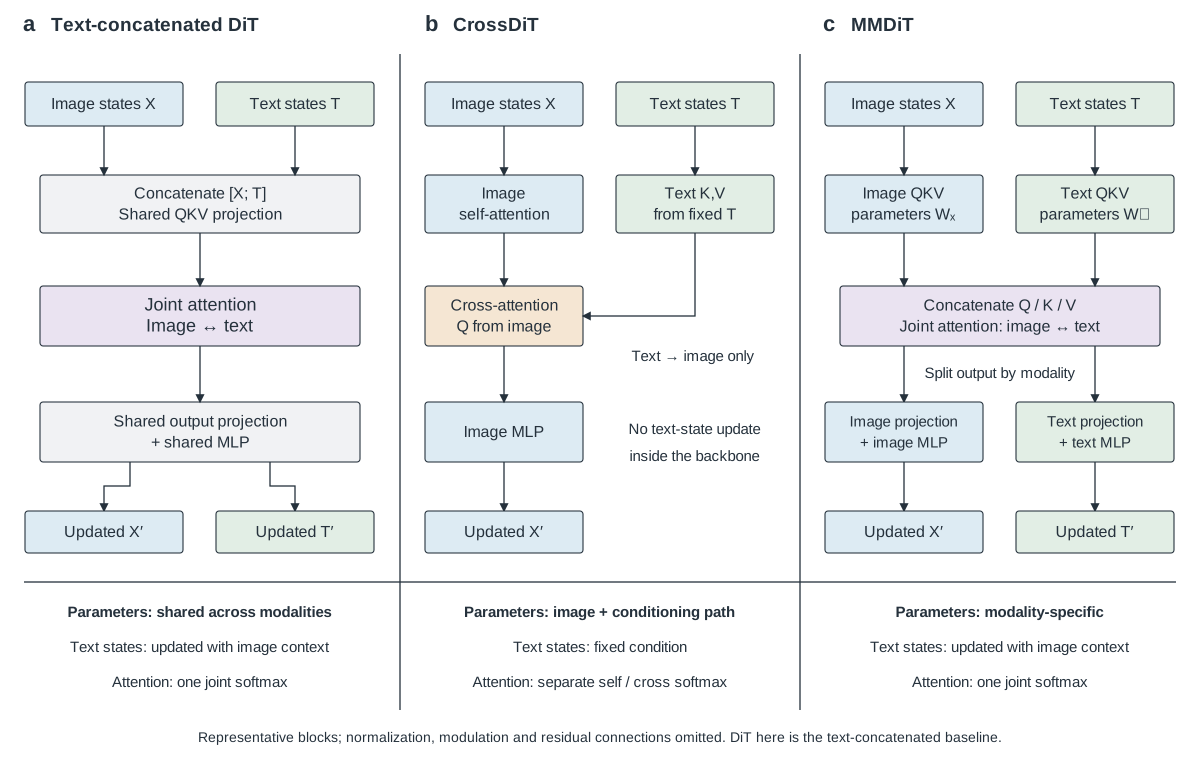
图2|三种文本条件 Transformer 的设计差异。a,拼接文本的 DiT 将图文状态组成统一序列,使用共享 QKV、输出投影和 MLP,两种模态的隐藏状态共同更新。b,CrossDiT 以图像为主干,先进行图像 self-attention,再以图像 query 读取文本 K/V;文本作为条件,不在主干中接收图像反馈。c,MMDiT 分别生成图文 QKV,拼接后进行联合 attention,再拆回各自的输出投影与 MLP。a、c 在全部图文 keys 上联合归一化,b 的 self-attention 与 cross-attention 分别归一化。图示为代表性 block,省略归一化、调制和残差连接;UViT 保留在表中作为多尺度主干参照。
三者的区别集中在两个设计选择上:拼接 DiT 与 MMDiT 都联合更新图文状态,但前者共享参数,后者保留模态独立参数;CrossDiT 则让图像主干读取文本,文本不随图像状态更新。 因而实验同时考察了参数组织和条件交互方式,而不仅是有没有 attention。
3.2 实验证据
下图将论文的三个原始子图并排展示。左、中两图比较不同主干的训练过程,回答“选择什么架构”;右图比较不同规模 MMDiT 的训练损失,回答“选定架构后如何扩大规模”。
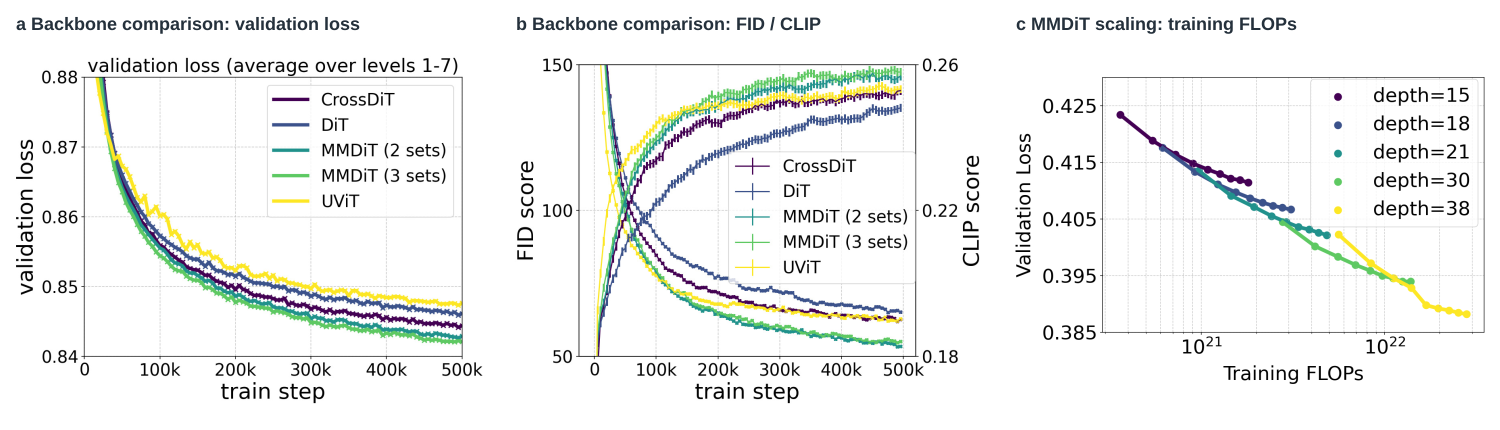
实验图|左:原论文 Figure 4 左图,验证损失越低越好。中:Figure 4 右图,左轴 FID 越低越好,右轴 CLIP score 越高越好;同色两条曲线分别对应两个指标。右:Figure 8 上排第二个子图,不同规模 MMDiT 的验证损失随训练 FLOPs 变化,横轴为对数刻度。来源:4,Figure 4、Figure 8。原图仅做等比例排版,未重绘或修改数据;可打开横排大图放大查看。

左、中两图以 CC12M 为训练集、COCO-2014 验证集为评估集,FID 使用 CLIP 特征;右图属于另一组大规模训练实验,不应跨组比较损失绝对值。右图中深度增加时隐藏宽度也随之增加,并非只改变层数的消融。
3.3 结果分析
1. 归纳偏置:早期学习效率与后期扩展潜力。
UViT 的多尺度视觉结构为学习提供了先验:模型不必完全从数据中发现如何组织局部细节和大范围信息。这可以解释它在训练初期的生成指标上进步较快。相比之下,规整的 DiT 主干对视觉层级结构的预设较少,需要通过训练形成有用的表示和交互方式,早期学习往往更慢。这里讨论的是两类结构的相对差异,DiT 的 patching 和位置编码本身仍然包含视觉归纳偏置。
随着训练推进,UViT 的早期优势不再扩大,MMDiT 在 FID 和 CLIP score 上逐渐占优。这提示一种可能的 scaling 取舍:更强的结构先验可以降低早期学习负担,但其预设的计算分配方式未必最适合更充分训练后的任务需求;更灵活的 Transformer 主干则可能需要更长训练,才能发挥容量。
2. 共享与独立模态参数:让新增容量服务于不同模态。
拼接文本的 DiT 与 MMDiT 都允许图文 tokens 联合交互,关键区别是它们如何分配参数。前者用同一套变换处理两种模态;后者保留图文各自的参数。作者给出的动机是图像和文本 embedding 性质不同,因此需要模态专门化,同时通过联合 attention 保持信息互通。[4, §4]
实验上,MMDiT 相对共享参数的拼接 DiT,在验证损失、FID 和 CLIP score 上均有改善。进一步将文本拆成 CLIP、T5 两路、采用三套参数,仅带来小幅收益,且增加参数与显存成本,因此作者选择两套参数。这说明模态专门化具有价值,但参数拆分也需要权衡边际收益。[4, §5.2.3]
3. MMDiT Scaling:模型容量与训练计算量共同增长。
横排图右侧把比较从“训练了多少步”推进到“投入了多少计算”。每条曲线对应一个模型规模:沿同一条曲线向右移动,表示该模型继续训练;切换到更大模型,则改变每一步的成本及可达到的损失。图中小模型在继续训练后收益趋缓,更大模型在获得足够预算时可以达到更低损失,但曲线在部分预算区间交叠,说明扩大模型并非在任意预算下都更划算。
论文通过同时增加深度和宽度扩容:若 block 数为 ,隐藏宽度设为 ,attention head 数为 。[4, §4] 在忽略输入输出层与常数后,主干参数量近似为 ;当 时,便有 。因此,“增加深度”在这组实验中代表显著的整体容量增长,而不只是增加几层计算。
训练预算则可以近似写成 ,其中 为样本呈现总次数。扩大模型会提高单样本成本,继续训练会增加 。固定总预算时,两者需要相互权衡;预算增长时,则要判断继续训练当前模型,还是将预算转向更大模型更有效。 右图中各规模曲线的下包络给出了这种权衡的经验线索。
参考文献
[1] Dhariwal & Nichol. Diffusion Models Beat GANs on Image Synthesis. NeurIPS, 2021. 原论文.
[2] Rombach et al. High-Resolution Image Synthesis with Latent Diffusion Models. CVPR, 2022. 原论文.
[3] Peebles & Xie. Scalable Diffusion Models with Transformers. ICCV, 2023. 原论文;重点阅读架构条件消融及 scaling 实验。
[4] Esser et al. Scaling Rectified Flow Transformers for High-Resolution Image Synthesis. ICML, 2024. 原论文;§4 架构、§5.2.3 主干对比、Appendix D 图像编辑。